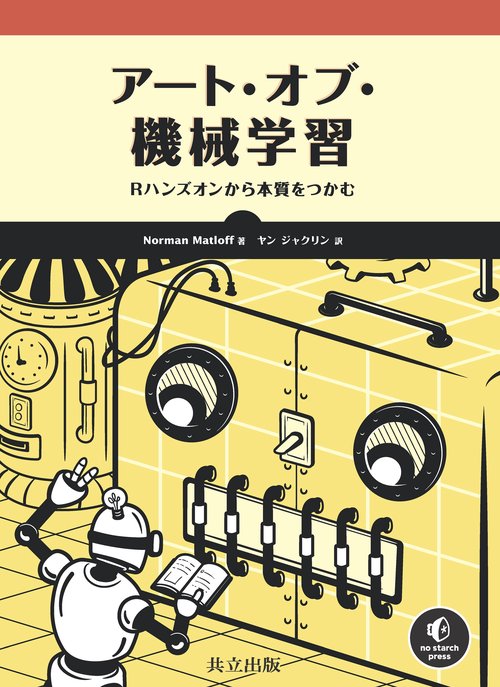
アート・オブ・機械学習
  • 発売日:2026/05/28
  • 出版社:共立出版
  • ISBN:9784320125971

サンプルサンプル

アート・オブ・機械学習

アート・オブ・機械学習

通常価格 4,180 円(税込)
通常価格 セール価格 4,180 円(税込)
SALE 売り切れ
  • 発売日:2026/05/28
  • 出版社:共立出版
  • ISBN:9784320125971
ネットストア在庫 詳細
    読み込み中...
My店舗在庫

    ほかの店舗在庫を見る

    ログインするとMy店舗登録で店頭在庫と
    店舗お受け取り可否が確認できます。

    新規会員登録
    ログイン ※パスワードお忘れの方はこちら
    商品説明
    機械学習はアートである
    分析の落とし穴を回避し、予測を成果に変える実践的ガイド

    本書は、「機械学習はサイエンスではなくアートである」という理念のもと、単なる分析手法の使い方を超えた、実務で役立つ知識を丁寧に伝える。機械学習を効果的に活用するための細やかなデータ加工やモデルの調整、例えば、データ分析において頻繁に直面する「過学習」や「不均衡なデータ」への対処法、ハイパーパラメータのチューニングなど、現場の経験に基づく知見をハンズオン形式で伝授する。
    本書では機械学習の最も重要な概念に焦点を当て、それぞれの手法をR言語によって実装する。直感的なビジュアル解説と共に、k近傍法から始まり、回帰、分類、ニューラルネットワーク、時系列解析など、幅広い手法を段階的に紹介。数学的な内容はできるだけ直感的に、グラフや図を通じた視覚的な説明に留められており、数式に不安のある読者でも無理なく読み進めることができる。
    また、機械学習の各手法をquickかつeasyに実装するために原著者が開発したqeMLパッケージを活用し、最小限のコードで学習・予測・評価・可視化できる点も魅力。実務での応用を見据え、初学者であっても機械学習を本質から理解したい読者に最適な実践書である。

    [原著]The Art of Machine Learning: A Hands-On Guide to Machine Learning with R, No Starch Press, 2024
    目次
    イントロダクション

    PART I 導入および近傍法ベースの手法

    第1章 回帰モデル
    1.1 例:バイクシェアのデータセット
    1.2 機械学習と予測について
    1.3 k近傍法(kNN)の導入
    1.4 ダミー変数とカテゴリカル変数
    1.5 qeKNN()を用いた分析
    1.6 回帰関数:機械学習の基礎
    1.7 バイアスとバリアンスのトレードオフ
    1.8 例:mlbデータセット
    1.9 kNNとカテゴリカル特徴量
    1.10 スケーリング
    1.11 ハイパーパラメータを選ぶ
    1.12 ホールドアウト・セット
    1.13 落とし穴:p値ハッキングとハイパーパラメータ選択
    1.14 落とし穴:長期トレンド
    1.15 落とし穴:汚いデータ
    1.16 落とし穴:欠損データ
    1.17 regtoolsのkNNコード
    1.18 まとめ

    第2章 分類モデル
    2.1 回帰の一種としての分類タスク
    2.2 例:Telco Churnデータセット
    2.3 例:脊椎データ
    2.4 落とし穴:誤差率がほとんど改善しない
    2.5 混同行列
    2.6 不均衡データのクリーニング
    2.7 ROC曲線とAUC
    2.8 まとめ

    第3章 バイアス,バリアンス,過学習,交差検証法
    3.1 過学習と学習不足
    3.2 交差検証法
    3.3 まとめ

    第4章 特徴量が多いときの対処法
    4.1 落とし穴:大きいデータに伴う計算コストの問題
    4.2 次元削減の導入
    4.3 次元削減の手法
    4.4 次元の呪い
    4.5 次元削減の他の手法
    4.6 計算に関する発展的な機能
    4.7 まとめ

    PART II 決定木ベースの分析手法

    第5章 kNNの次のステップ:決定木
    5.1 決定木の基本知識
    5.2 qeDT()関数
    5.3 例:ニューヨーク市内のタクシーのデータ
    5.4 例:Forest Coverデータセット
    5.5 決定木のハイパーパラメータ:分割の基準
    5.6 qeDT()関数のハイパーパラメータ
    5.7 まとめ

    第6章 決定木モデルの調整
    6.1 バイアスとバリアンス,バギングとブースティング
    6.2 バギング:再サンプリングによる新しいツリー
    6.3 ブースティング:ツリーの調整を繰り返す
    6.4 落とし穴:ノーフリーランチの定理

    第7章 ハイパーパラメータの良い組み合わせを見つける
    7.1 ハイパーパラメータの組み合わせ
    7.2 qeFT()を用いたグリッドサーチ
    7.3 例:プログラマとエンジニアの収入
    7.4 例:プログラマとエンジニアの職業
    7.5 例:音素データ
    7.6 まとめ

    PART III 線形モデル線形関係に基づく手法

    第8章 パラメトリックモデル
    8.1 例:野球選手のデータ
    8.2 lm()関数
    8.3 qe*シリーズのlm()ラッパー関数:qeLin()
    8.4 複数の特徴量の使用
    8.5 次元削減
    8.6 最小二乗法と残差
    8.7 診断:線形モデルは有効なのか?
    8.8 決定係数R2
    8.9 分類への応用:ロジスティック回帰モデル
    8.10 (一般化)線形モデルにおけるバイアスとバリアンス
    8.11 多項式モデル
    8.12 線形モデルと他の手法の組み合わせ
    8.13 qeCompare()関数
    8.14 次に学ぶこと

    第9章 縮小推定と正則化
    9.1 正則化を行う理由
    9.2 ベクトルのサイズ
    9.3 リッジ回帰とLASSO回帰
    9.4 ソフトウエア
    9.5 例:ニューヨーク市内のタクシーのデータセット
    9.6 例:Airbnbデータ
    9.7 例:アフリカ土壌データ
    9.8 補足:有名なLASSOの図
    9.9 次章以降について

    PART IV データを線や平面で分離する手法

    第10章 境界線を用いたアプローチ:サポートベクトルマシン
    10.1 SVMを使用する動機
    10.2 直線,平面,超平面
    10.3 数学的な記法
    10.4 SVMの基本的な考え方:分離可能な場合
    10.5 重大な問題:線形分離不可能
    10.6 例:Forest Coverデータ
    10.7 カーネルトリックとは
    10.8 警告:反復回数の上限
    10.9 まとめ

    第11章 強化された線形モデル:ニューラルネットワーク
    11.1 ニューラルネットワークの概要
    11.2 複雑な構造を扱う
    11.3 例:脊椎データ
    11.4 ニューラルネットワークのハイパーパラメータ
    11.5 活性化関数
    11.6 正規化
    11.7 例:転倒検知データ
    11.8 落とし穴:収束の問題
    11.9 多項式回帰との密接な関係
    11.10 ニューラルネットワークにおけるバイアスとバリアンス
    11.11 議論

    PART V 応用

    第12章 画像分類
    12.1 例題: Fashion MNISTデータ
    12.2 畳み込みモデル
    12.3 精度向上に向けた秘訣
    12.4 過学習の問題はどうなったのか
    12.5 まとめ

    第13章 時系列データとテキストデータ
    13.1 時系列データの変換
    13.2 qeTS()関数
    13.3 例:天候データ
    13.4 バイアスとバリアンス
    13.5 テキストへの応用
    13.6 まとめ

    付録
    A.1 行列,データフレーム,factor型の変換
    A.2 落とし穴:p値ハッキングに注意
    詳細を表示する

    カスタマーレビュー

    honto本の通販ストアのレビュー(0件)

    並び順:
    1/1ページ

    最近チェックした商品

    丸善ジュンク堂書店 公式YouTubeチャンネル

    真夜中の本屋で語る田辺青蛙の「大阪怪談」|ミッドナイトジュンクラブ

    動画に関連する商品より
    御堂筋線怪談
    御堂筋線怪談

    小原猛の真夜中 怪談話|ミッドナイトジュンクラブ

    動画に関連する商品より
    琉球怪談 第二版
    琉球怪談 第二版